0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
What Is Data Poisoning? How Attackers Corrupt AI Models and Datasets (원문, 새 창)
한국어 요약
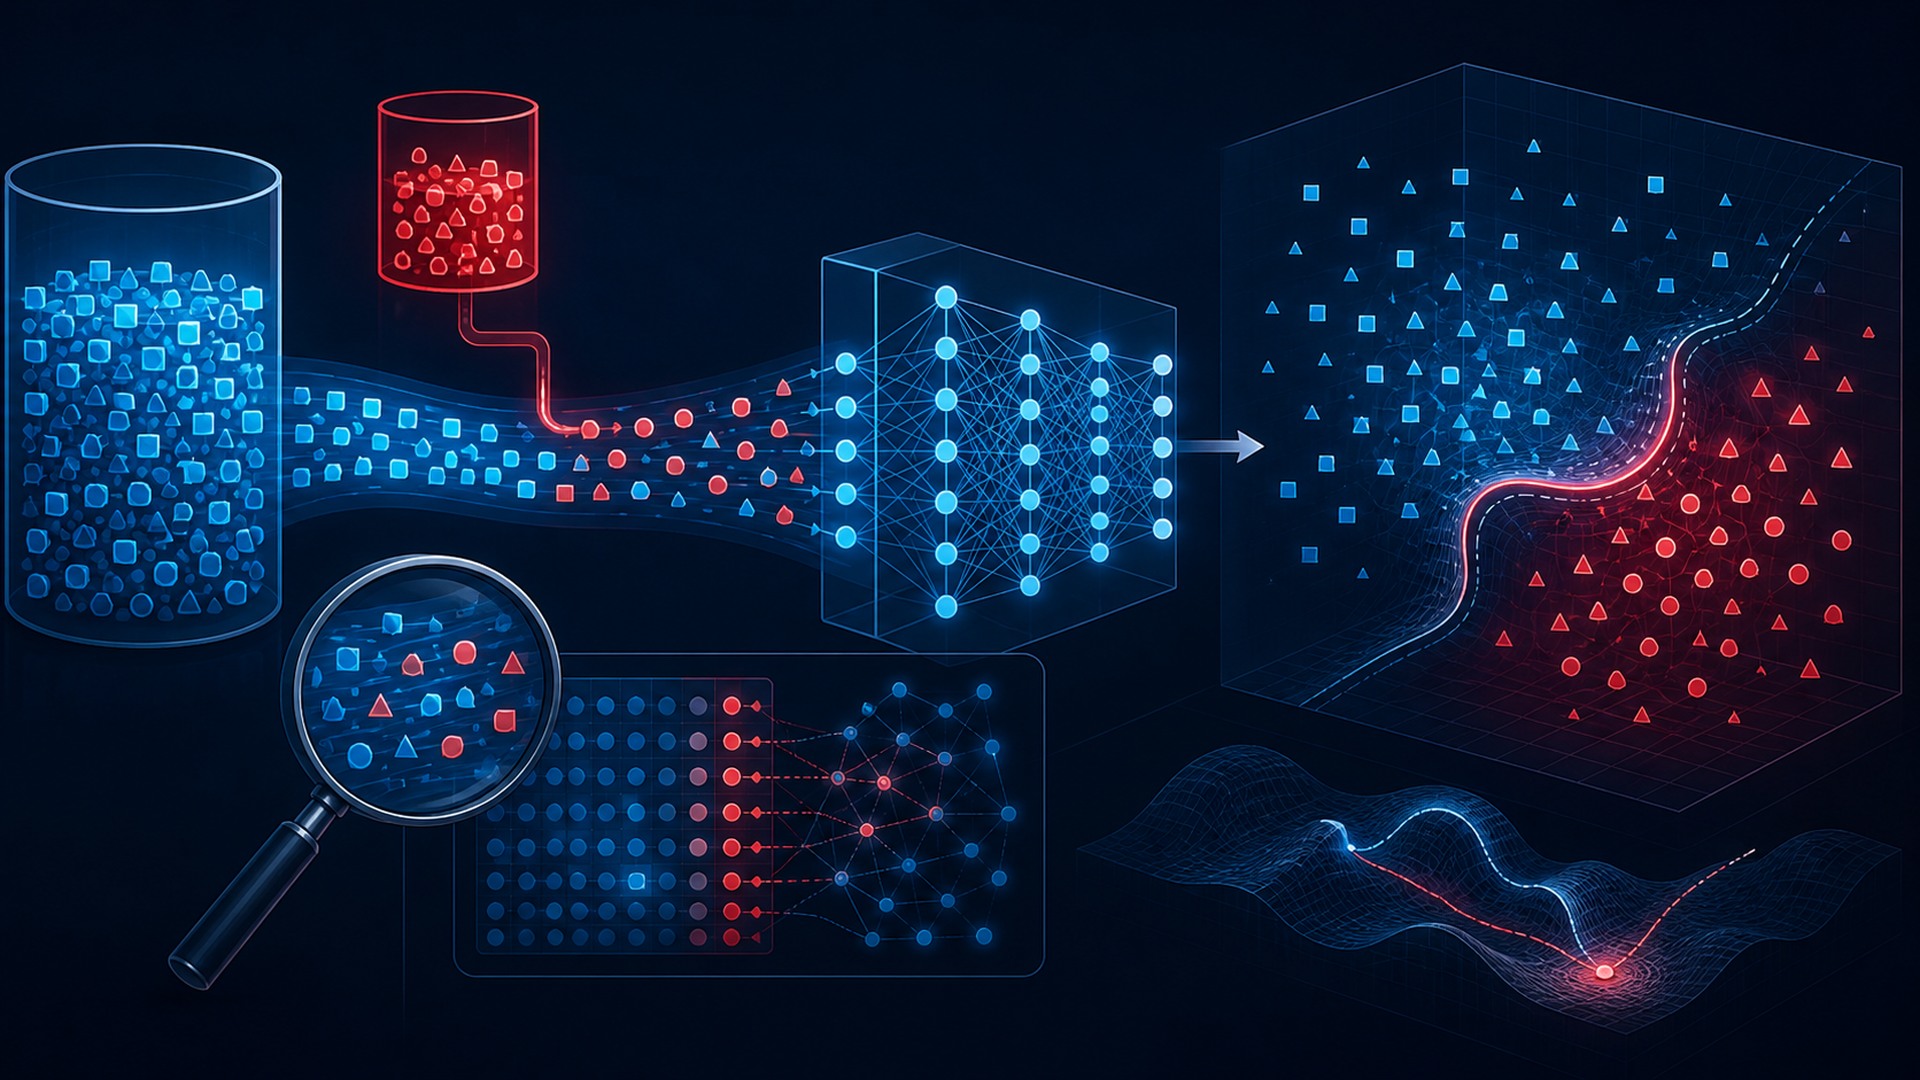
Claude · 2026-10-26데이터 포이즈닝(Data Poisoning)은 공격자가 학습·파인튜닝·평가 또는 검색 데이터를 조작해 AI 시스템이 오염된 행동을 학습하거나 공격자가 의도한 결과를 내도록 만드는 기법이다. 기사는 이를 데이터 소스 장악→오염된 예시 삽입→필터링 생존→학습된 모델·검색 결과 변조→광범위한 성능 저하 또는 특정 백도어 활성화의 5단계 과정으로 설명한다. 핵심 위험은 소량의 표적화된 오염 데이터가 웹 규모의 대규모 데이터셋 속에서 탐지되기 어렵다는 점으로, 단순히 배포 후 발생하는 '회피 공격'과는 구분되는 개념이다. 글은 조직이 데이터 수집·아키텍처·권한·평가·모니터링 단계에서 이 위험을 사전에 반영하고, 명확한 기준선과 비교 실험으로 대응책의 실효성을 검증해야 한다고 권고한다.
- 데이터 포이즈닝: 학습·파인튜닝·평가·검색 데이터를 조작해 AI가 오염된 결과를 내도록 하는 공격
- 데이터 소스 장악→오염 예시 삽입→필터링 생존→모델 변조→결함 활성화의 5단계 메커니즘
- 핵심 위험은 소량의 표적 오염 데이터가 웹 규모 데이터셋에서 탐지되기 어렵다는 점
- 배포 후 발생하는 '회피 공격'과는 구분되는 별개의 공격 유형으로 설명
- NIST AI 위험관리 프레임워크 등을 참고해 수집·평가·모니터링 전 단계에서 대응 필요
AI 인사이트
- 데이터 포이즈닝은 학습·검색 데이터를 조작해 AI가 공격자 의도대로 오작동하게 만드는 공격
- 데이터 장악→오염 삽입→필터링 우회→모델 변조→광범위 저하 또는 표적 백도어의 5단계
- 핵심 위험은 웹 규모 데이터 속 극소수 표적 샘플이 탐지되기 어렵다는 점
- NIST AI 위험관리 프레임워크·C2PA 등을 1차 참고자료로 제시
왜 중요한가
데이터 포이즈닝을 배포 후 공격(에바전)과 별개의 위협으로 구분해, AI 도입 기업이 데이터 공급망 검증과 계보 관리 등 구체적 방어체계를 갖춰야 함을 강조한다.
언급 프로젝트
본문 미리보기
Data poisoning manipulates training, fine-tuning, evaluation, or retrieval data so an AI system learns corrupted behavior or produces attacker-chosen outcomes. This guide explains the mechanism, trade-offs, evaluation, and controls that matter in practice.
전체 내용이 궁금하다면?
Unite.AI에서 원문을 직접 읽어보세요
- #데이터포이즈닝
- #AI보안
- #모델공격
이 글이 만들어진 과정
- 10:59AI 초안