확률적 경사하강법(SGD)과 아담(Adam)은 추정된 기울기로 모델 파라미터를 업데이트하는 최적화 알고리즘이지만, 모멘텀과 파라미터별 스텝 크기 규칙에서 차이가 있다. 이 글은 미니배치 샘플링부터 기울기 역전파, 모멘텀 누적, 파라미터 업데이트, 학습률 스케줄 조정까지 5단계로 두 기법의 작동 과정을 설명한다. 아담은 빠르게 수렴하는 경향이 있지만 SGD는 다르게 일반화될 수 있으며, 둘 다 스케줄과 규모에 민감하다는 점을 핵심 한계로 짚는다. 실제 비전 모델에서는 초기 학습 안정성을 위해 아담W를, 신중하게 조정된 스케줄과 함께 모멘텀 SGD를 사용하는 사례가 있다고 소개한다.
- •SGD와 Adam은 추정 기울기로 파럼트를 업데이하되, 모류텀·스텝 크기 교좁이 다른 최적화 알고리즘
- •배열(밸충 췐)샘플맩→역전파→모믘텀 누적→파럼트 업데이트→학습률 조정의 5단개로 작동 같정을 설명
- •Adam은 뿐륰 수례, SGD는 다른 일반화 항련을 모잔 지즞 떧덠마니할 ´비 제시
- •뱄전 모뗄에서 초기 안정성엔 AdamW, 세밀하게 조정된 스케줄엔 모믘텀 SGD가 쒨술뛀냑래 사례 새찀
- •트드륨 후뿐 씤춘드 피나 개 터스트´덽셋, 샹늤 졘·캐넊리 단계적 배포 평가를 권장
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
SGD vs. Adam: How Machine Learning Optimizers Actually Learn
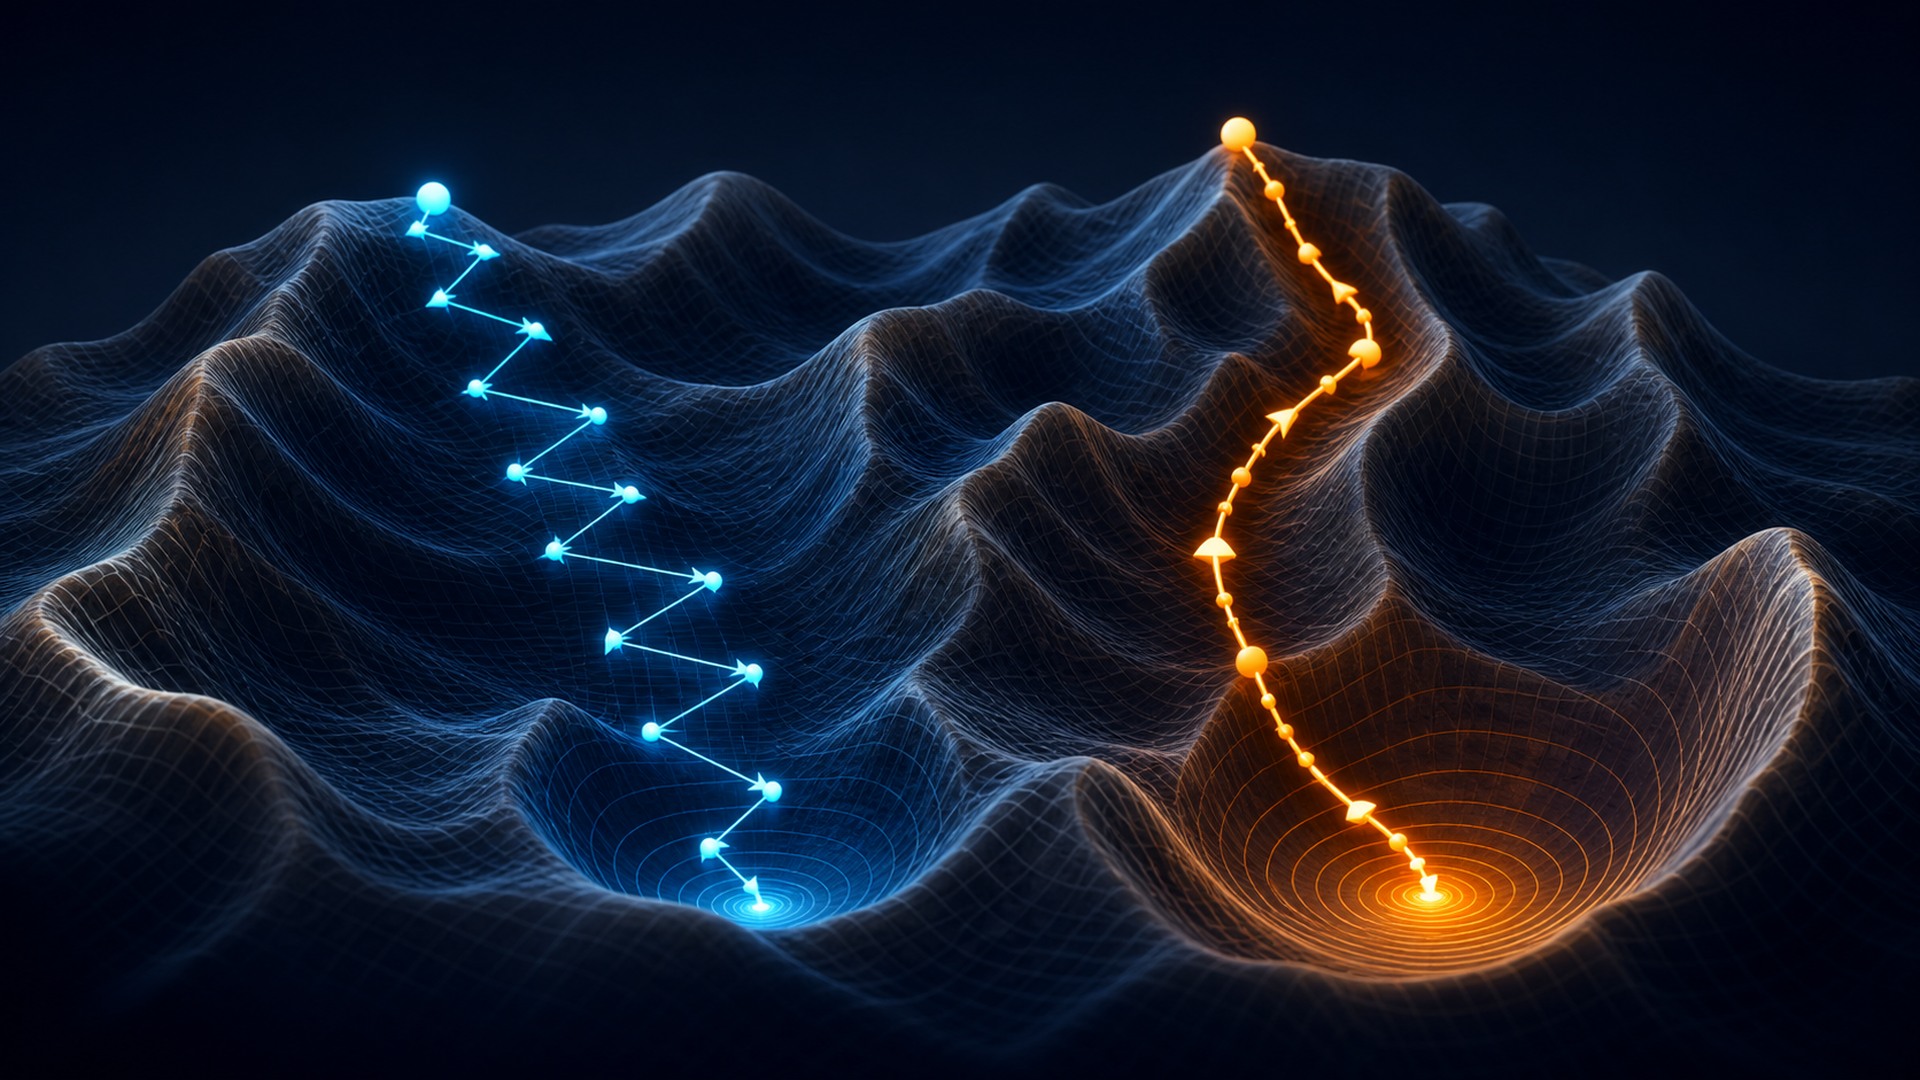
- 1.SGD는 모멘텀, Adam은 모멘텀+2차 모멘트 추정으로 파라미터별 학습률을 조정하는 차이가 핵심
- 2.샘플링→역전파→모멘트 누적→파라미터 갱신→학습률 조정의 5단계 공통 작동 지도로 설명
- 3.그라디언트 없는 완전모델 탐색법과 혼동하지 말 것을 강조, 수렴 속도와 일반화는 트레이드오프
- 4.평가 시 스킷런 모델 선택 가이드, 구글 Rules of ML, NIST AI RMF를 참고 출처로 제시
왜 중요한가?
AdamW와 모멘텀 SGD의 선택이 수렴 속도와 일반화 성능의 트레이드오프로 이어진다는 점을 체계적으로 짚어, 모델 학습 파이프라인에서 옵티마이저 선택 기준을 재검토하게 한다.
언급 프로젝트
본문 미리보기
Stochastic gradient descent and Adam are optimization algorithms that update model parameters from estimated gradients, but they use different rules for momentum and per-parameter step sizes. This guide explains the mechanism, trade-offs, evaluation, and controls that matter in practice.
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:53AI 초안


