한국어 요약by Claude · 2026. 8. 11.
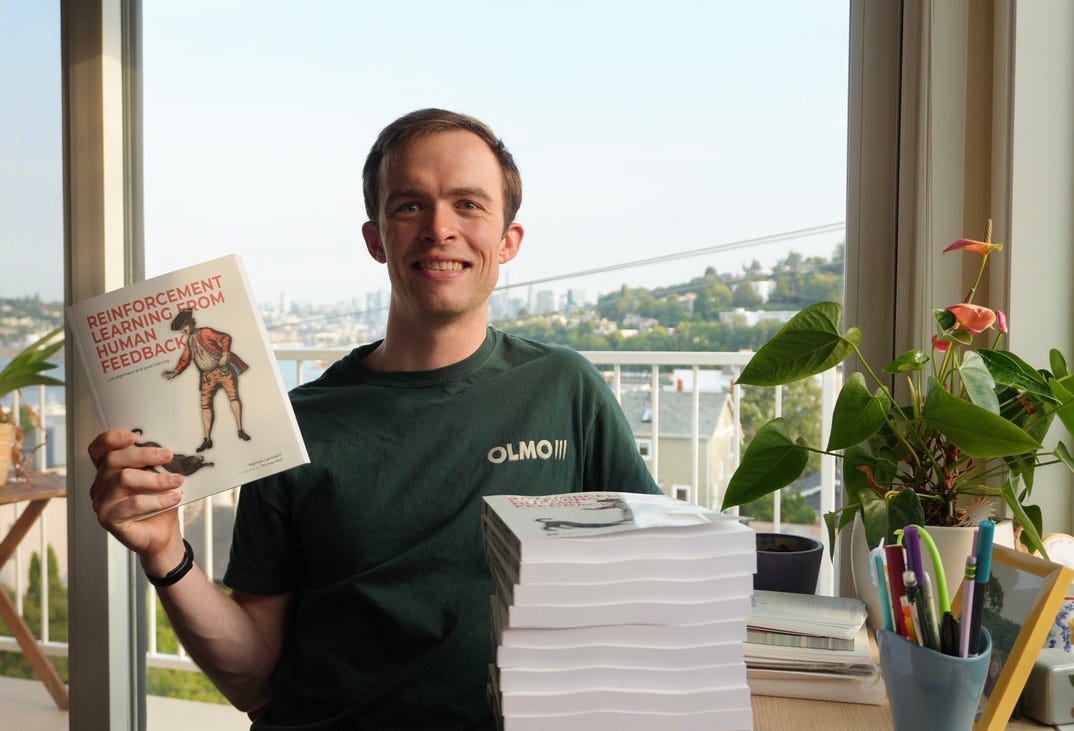
AI 연구자 네이선 램버트가 강화학습 기반 사후학습(post-training)을 다룬 신간 'Reinforcement Learning from Human Feedback: Aligning and Post-training LLMs'를 출간했다고 밝혔다. 책은 정책경사(policy gradient)부터 PPO, GRPO, GSPO, CISPO 등 최신 RL 알고리즘까지 직관적으로 설명하며, 비동기 RL 시스템 설계 등 실무 엔지니어링 문제도 다룬다. 후반부에서는 증류(distillation)의 기술적 실체를 상세히 설명해 지정학적 논쟁의 대상이 된 이 개념을 명확히 하고, 과최적화·정규화·평가·캐릭터 트레이닝 등 사후학습에서 흔히 겪는 함정도 폭넓게 다룬다. 책은 온라인에서 무료로도 볼 수 있으며 12시간 분량의 강의 영상과 코드 예제도 함께 제공된다.
- •네이선 램버트, 사후학습(post-training) 전문서 'RLHF: Aligning and Post-training LLMs' 출간
- •정책경사·PPO·GRPO·GSPO·CISPO 등 최신 RL 알고리즘을 직관적으로 설명
- •비동기 RL 시스템, 학습-추론 불일치 등 실무 엔지니어링 이슈도 다룸
- •증류(distillation) 챕터에서 지정학적 논쏁이 된 개념을 기술적으로 명확히 설명
- •온라인 무료 열람 가능, 12시간 강의 영상·코드 예제 동반 제공
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
5 useful things you'll learn in my new post-training textbook (shipping now!)
출처:Interconnects AI (Nathan Lambert)
본문 미리보기
After a few long years of finding time to document my lessons from training open models, my post-training book is done!
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
공유:
이 글이 만들어진 과정
- 10:52AI 초안


