엔비디아가 여러 AI 모델을 오가는 장시간 에이전트 작업에서 모델 전환 시 발생하는 재계산 부담, 이른바 '라우팅 병목'을 줄이는 '크로스 모델 KV 캐시 전송' 기술을 아카이브(arXiv)를 통해 공개했다. 헤드별 릿지 회귀라는 간단한 선형 변환으로 한 모델의 KV 캐시를 다른 모델이 바로 쓸 수 있는 형태로 바꾸는 방식으로, 큐원3·라마3.1·미스트랄3 등 3개 모델 계열 6개 조합에서 실험한 결과 문맥을 처음부터 다시 처리했을 때 대비 정확도를 73~98%까지 유지하면서 속도는 2.7배에서 최대 25배 빨라졌다. 큐원3 14B와 32B 실험에서는 여러 레이어 정보를 함께 활용했을 때 키(Key) 정보 변화량의 79%, 값(Value) 정보 변화량의 65%까지 설명할 수 있었다. 일부 미스트랄3 조합에서는 단순 선형 방식의 정확도가 크게 떨어졌지만, 비선형 MLP를 적용해 정확도를 최대 37%포인트까지 끌어올렸다.
- •엔비디아, 모델간 KV캐시 변환으로 재계산 없이 이어받는 기술 공개
- •헤드별 릿지회귀로 큐원3·라마3.1·미스트랠3 6개 조합서 검증
- •정확도 73~98% 유지하며 속도 2.7~25배 향상
- •일부 조합은 비선형 MLP 적용해 정확도 최대 37%p 개선
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
엔비디아, AI 모델 라우팅 병목 뚫었다...‘선형 연산’으로 KV 캐시 전송 성공
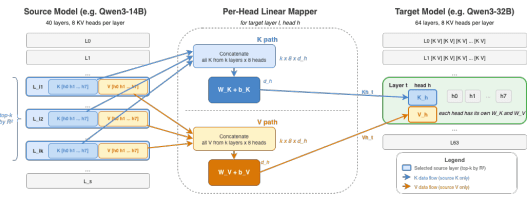
- 1.엔비디아, 모델 전환 시 KV 캐시를 다시 계산하지 않고 변환해 재사용하는 '크로스모델 KV 캐시 전송' 기술 공개
- 2.헤드별 릿지 회귀라는 간단한 선형 변환만으로 큐원314B→32B 간 K정보 79%, V정보 65% 설명 가능함을 확인
- 3.큐원3·라마 3.1·미스트랄 3 등 6개 모델 조합에서 정확도를 원본 프리필 대비 73~98% 유지하면서 속도는 2.7~25배 향상
- 4.보정용 데이터 500개만으로 변환식 생성 가능, 일부 미스트랄 조합은 선형 방식 한계로 비선형 MLP 대체 시 정확도 최대 37%p 개선
왜 중요한가?
여러 모델을 번갈아 쓰는 AI 에이전트 워크플로우에서 모델 전환마다 전체 문맥을 재계산해야 했던 근본 병목을 간단한 선형 변환만으로 해소할 가능성을 실증했다는 점에서, 멀티모델 라우팅 기반 에이전트 시스템의 비용·지연시간을 크게 낮출 실용 기술로 주목된다.
본문 미리보기
엔비디아가 여러 AI 모델을 번갈아 사용하는 장시간 AI 에이전트 작업에서 다른 모델로 전환할 때 발생하는 막대한 연산 비용과 지연시간 등 '라우팅 병목'을 줄일 수 있는 새로운 기술을 제시했다. 엔비디아는 최근 AI 모델이 축적한 KV(Key-Value) 캐시를 다른 모델이 그대로 재활용할 수 있도록 변환하는 ‘크로스 모델 KV 캐시 전송(Cross-Model KV Cache Transfer)’ 기술을 온라인 아카이브를 통해 공개했다.기존에는 AI가 대화 도중 더 큰 모델이나 더 저렴한 모델로 전환할 때 수신 모델이 누적된 대화
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 11:24AI 초안


