AIAI as Normal TechnologyAI 점수 85%
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
New paper: Emerging trends in AI agent evaluation (원문, 새 창)
한국어 요약
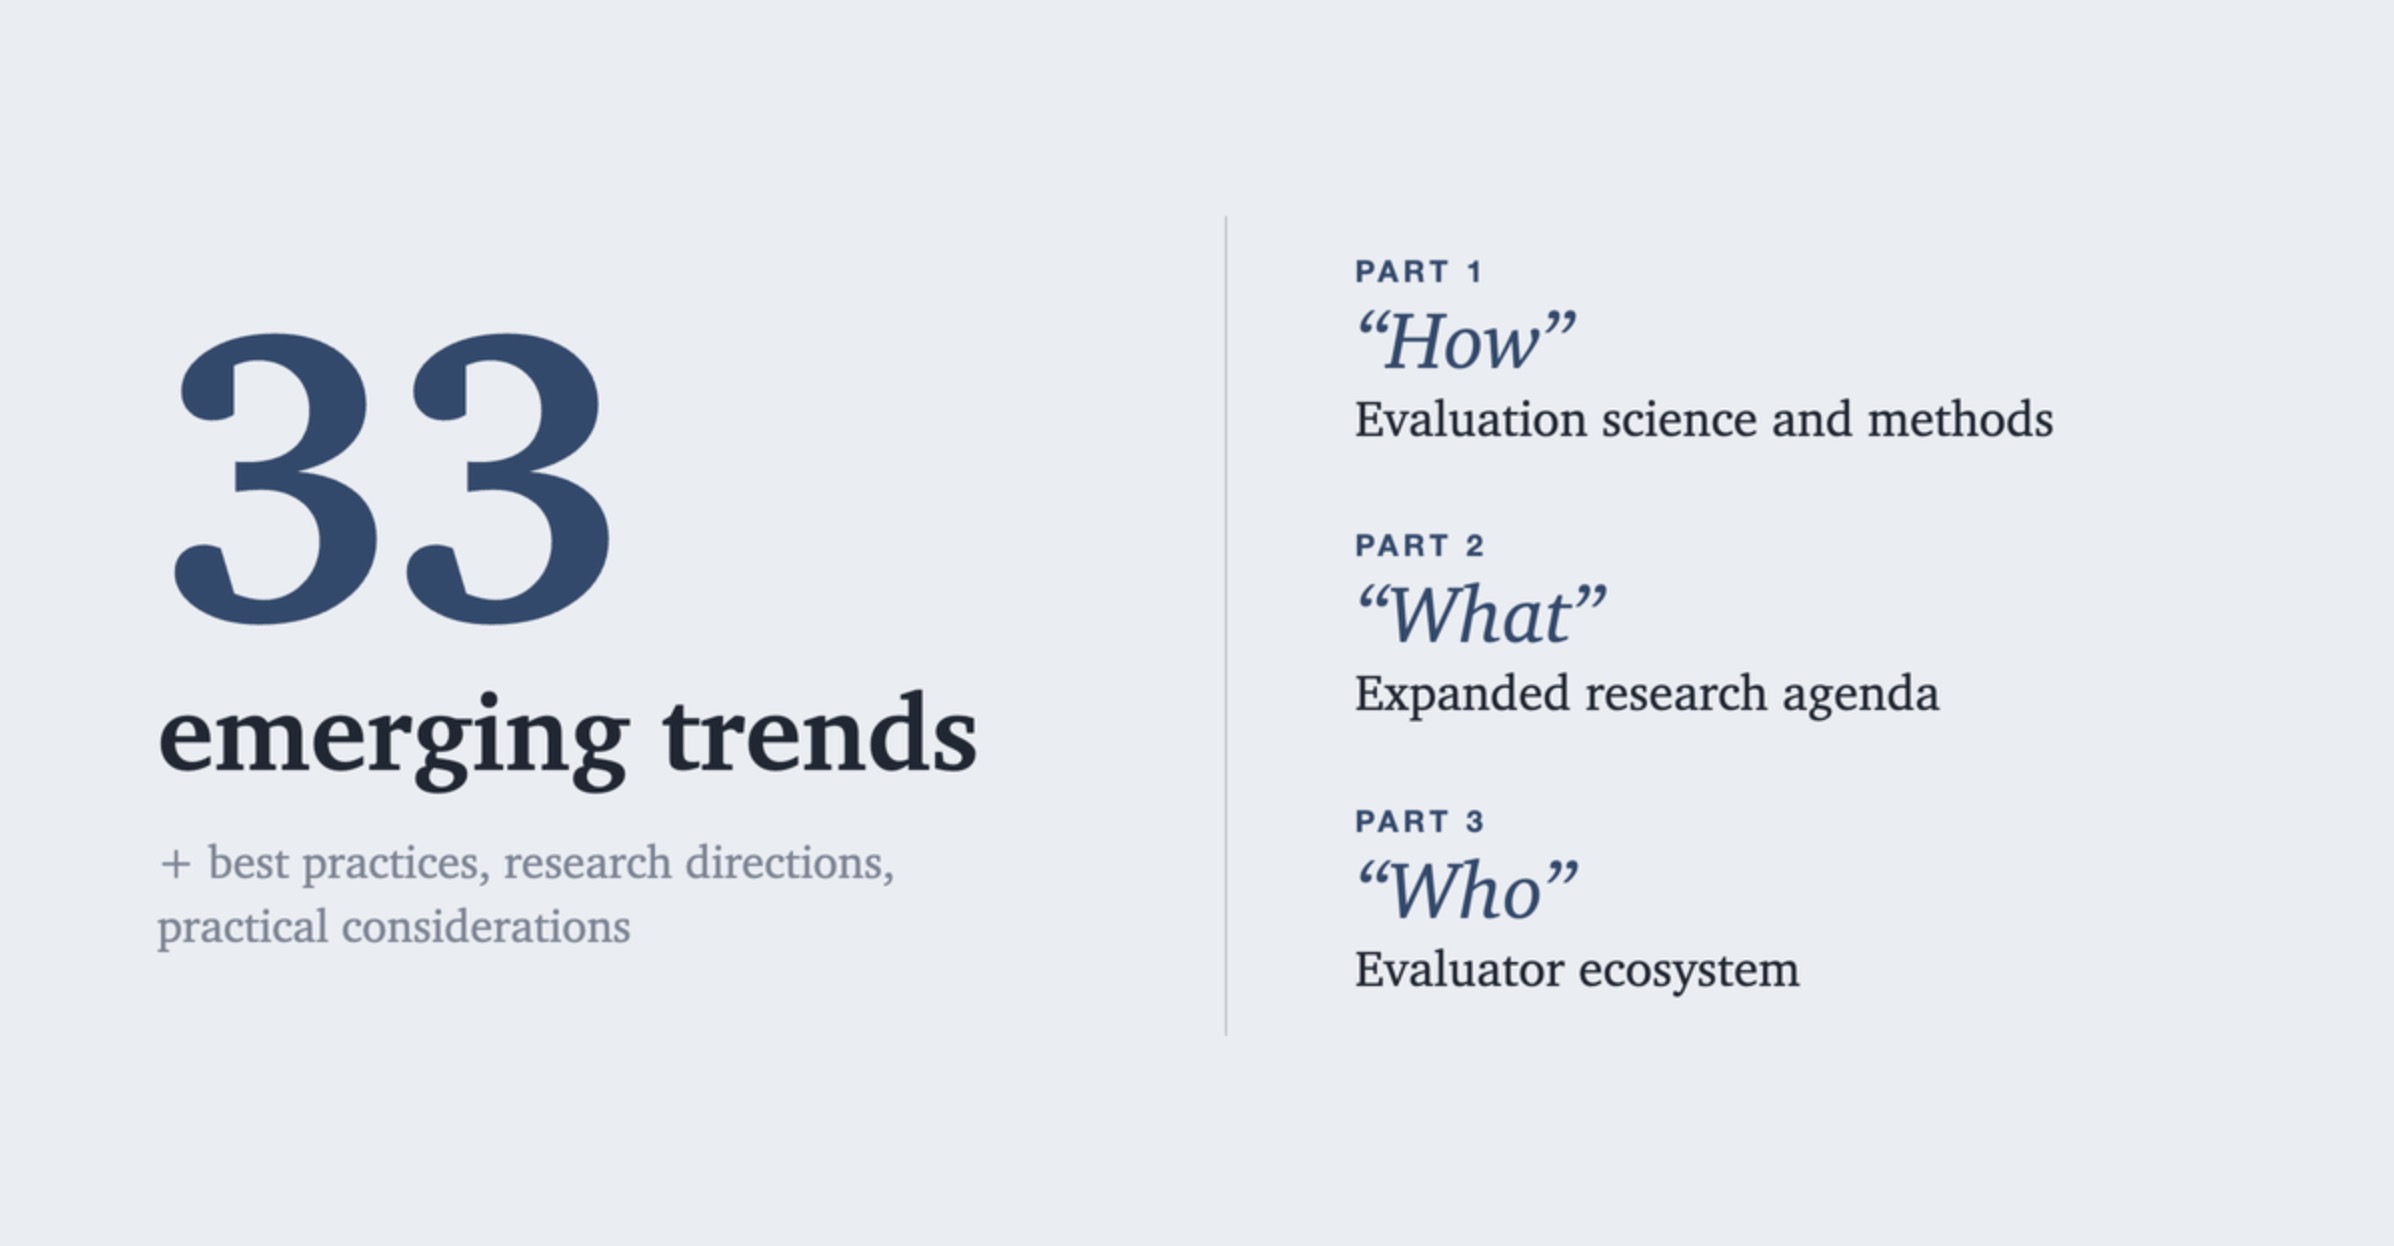
Claude · 2026-10-20프린스턴대 사야시 카푸어·아르빈드 나라야난 연구팀이 스탠퍼드, 영국 AI안전연구소, 브루킹스 연구진과 함께 'AI 에이전트 평가의 새로운 흐름'이라는 논문을 발표하고 33가지 신흥 평가 동향을 제시했다. 논문은 에이전트가 도구와 환경에 접근할 수 있어 전체 행동 경로를 검토해야 하는 점, 평가 인프라 구축에 ExploitBench 등에서 수만 달러가 소요되는 등 비용이 급증하는 점을 주요 과제로 지적했다. 또한 METR의 무작위 대조 실험에서 에이전트 도구 사용이 오히려 소프트웨어 개발 완료 시간을 늘린 사례처럼, 실험실 성능이 실제 활용 맥락으로 그대로 이어지지 않는다는 점도 강조했다. 연구진은 평가자, 자금지원기관, 정책입안자 등 다양한 이해관계자에게 독립성과 투명성을 갖춘 평가 생태계 구축을 위한 실천 과제를 제안했다.
- 프린스턴·스탠퍼드·영국 AI안전연구소 등 공동 논문, AI 에이전트 평가 33가지 동향 제시
- ExploitBench 등 일부 벤치마크는 평가에 수만달러 소요, 비용 급증이 과제
- METR 무작위 대조실험, 에이전트 도구 사용이 오히려 작업 완료 시간 증가시킨 사례 소개
- 평가자 독립성·투명성·학제간 참여 확대를 핵심 권고로 제시
AI 인사이트
대상 독자:개발자투자자
- 프린스턴·스탠퍼드·英 AI안전연구소 공동, 'AI 에이전트 평가의 신흥 트렌드' 논문서 트렌드 33개 정리
- ExploitBench 등 일부 에이전트 벤치마크는 평가에만 수만 달러 비용이 소요될 정도로 고비용화
- METR의 무작위 대조 실험은 에이전트 도구 사용이 개발 완료 시간을 오히려 늘렸다는 결과 보고
- 프런티어 랩들이 전체 사고과정(CoT) 대신 요약본만 공개, 평가자 접근성이 제한된다는 점도 지적
왜 중요한가
에이전트 평가가 단순 모델 성능 측정에서 하네스·실사용 맥락까지 포괄해야 하는 복잡한 과학으로 진화하고 있음을 체계적으로 정리한 연구로, 평가 생태계의 재현성·독립성 기준을 세우는 데 실질적 가이드가 될 수 있다.
본문 미리보기
Understanding the methods, questions, and ecosystem for evaluation
전체 내용이 궁금하다면?
AI as Normal Technology에서 원문을 직접 읽어보세요
공유
- #AI에이전트평가
- #연구논문
이 글이 만들어진 과정
- 10:46AI 초안