중국 홍콩중문대·알리바바 퉁이(Qwen)·Liblib AI 공동 연구팀이 실시간 전신 딥페이크 영상 생성 프레임워크 'LiveAnimate'를 공개했다. 기존 Wan2.2-Animate는 오프라인에서 전체 시퀀스를 한꺼번에 계산해야 했지만, LiveAnimate는 과거 프레임 일부를 메모리로 유지하는 'Pose-Retrieval Sink Attention' 기법으로 매 구간을 3단계 추론만으로 실시간 생성한다. H100 GPU 2장 기준 초당 19.63프레임을 달성했으며, 3분간 연속 생성해도 화질과 인물 정체성이 거의 저하되지 않아 기존 오프라인 방식(2~5시간 소요)을 크게 앞섰다. 연구진은 이 기술이 라이브 스트리밍, 텔레프레즌스, 가상 아바타 등 실시간 응용의 새로운 기준점을 제시한다고 밝혔다.
- •H100 GPU 2장으로 초당 19.63프레임 실시간 생성, 3분 연속 생성해도 화질·정체성 거의 유지
- •기존 오프라인 방식은 동일 영상 생성에 2~5시간 소요, LiveAnimate는 약 4분
- •'Pose-Retrieval Sink Attention'으로 과거 자세 5개를 메모리뱅크에 저장해 정체성 유지
- •2단계 학습으로 50단계였던 디노이징을 3단계로 압축해 실시간 구동 가능하게 함
- •홍콩중문대·알리바바 통이·Liblib AI 공동 연구, 코드는 추후 공개 예정
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
Toward Perpetual Full-Body Deepfake Video Generation
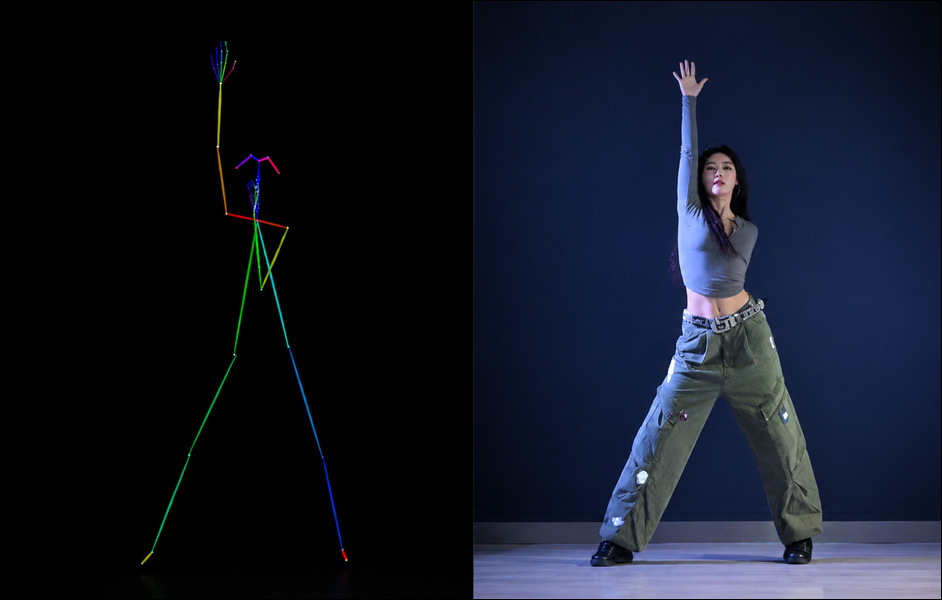
본문 미리보기
In a field where patience is required, a new system pushes us a little nearer to live-streamed human simulation without frustrating rendering rounds. The state-of-the-art in full-length human simulation has come a long way since the possibility of full-body deepfakes first appeared in 2022. By now we have become habituated to the formidable and often-controversial ability of open source systems such as Wan-Animate, and closed-source systems such as Grok, to convert single or multiple images…
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:47AI 초안


