AIAhead of AI (Sebastian Raschka)AI 점수 95%
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
Building Reasoning Models from the Ground Up: A Full Video Course (원문, 새 창)
한국어 요약
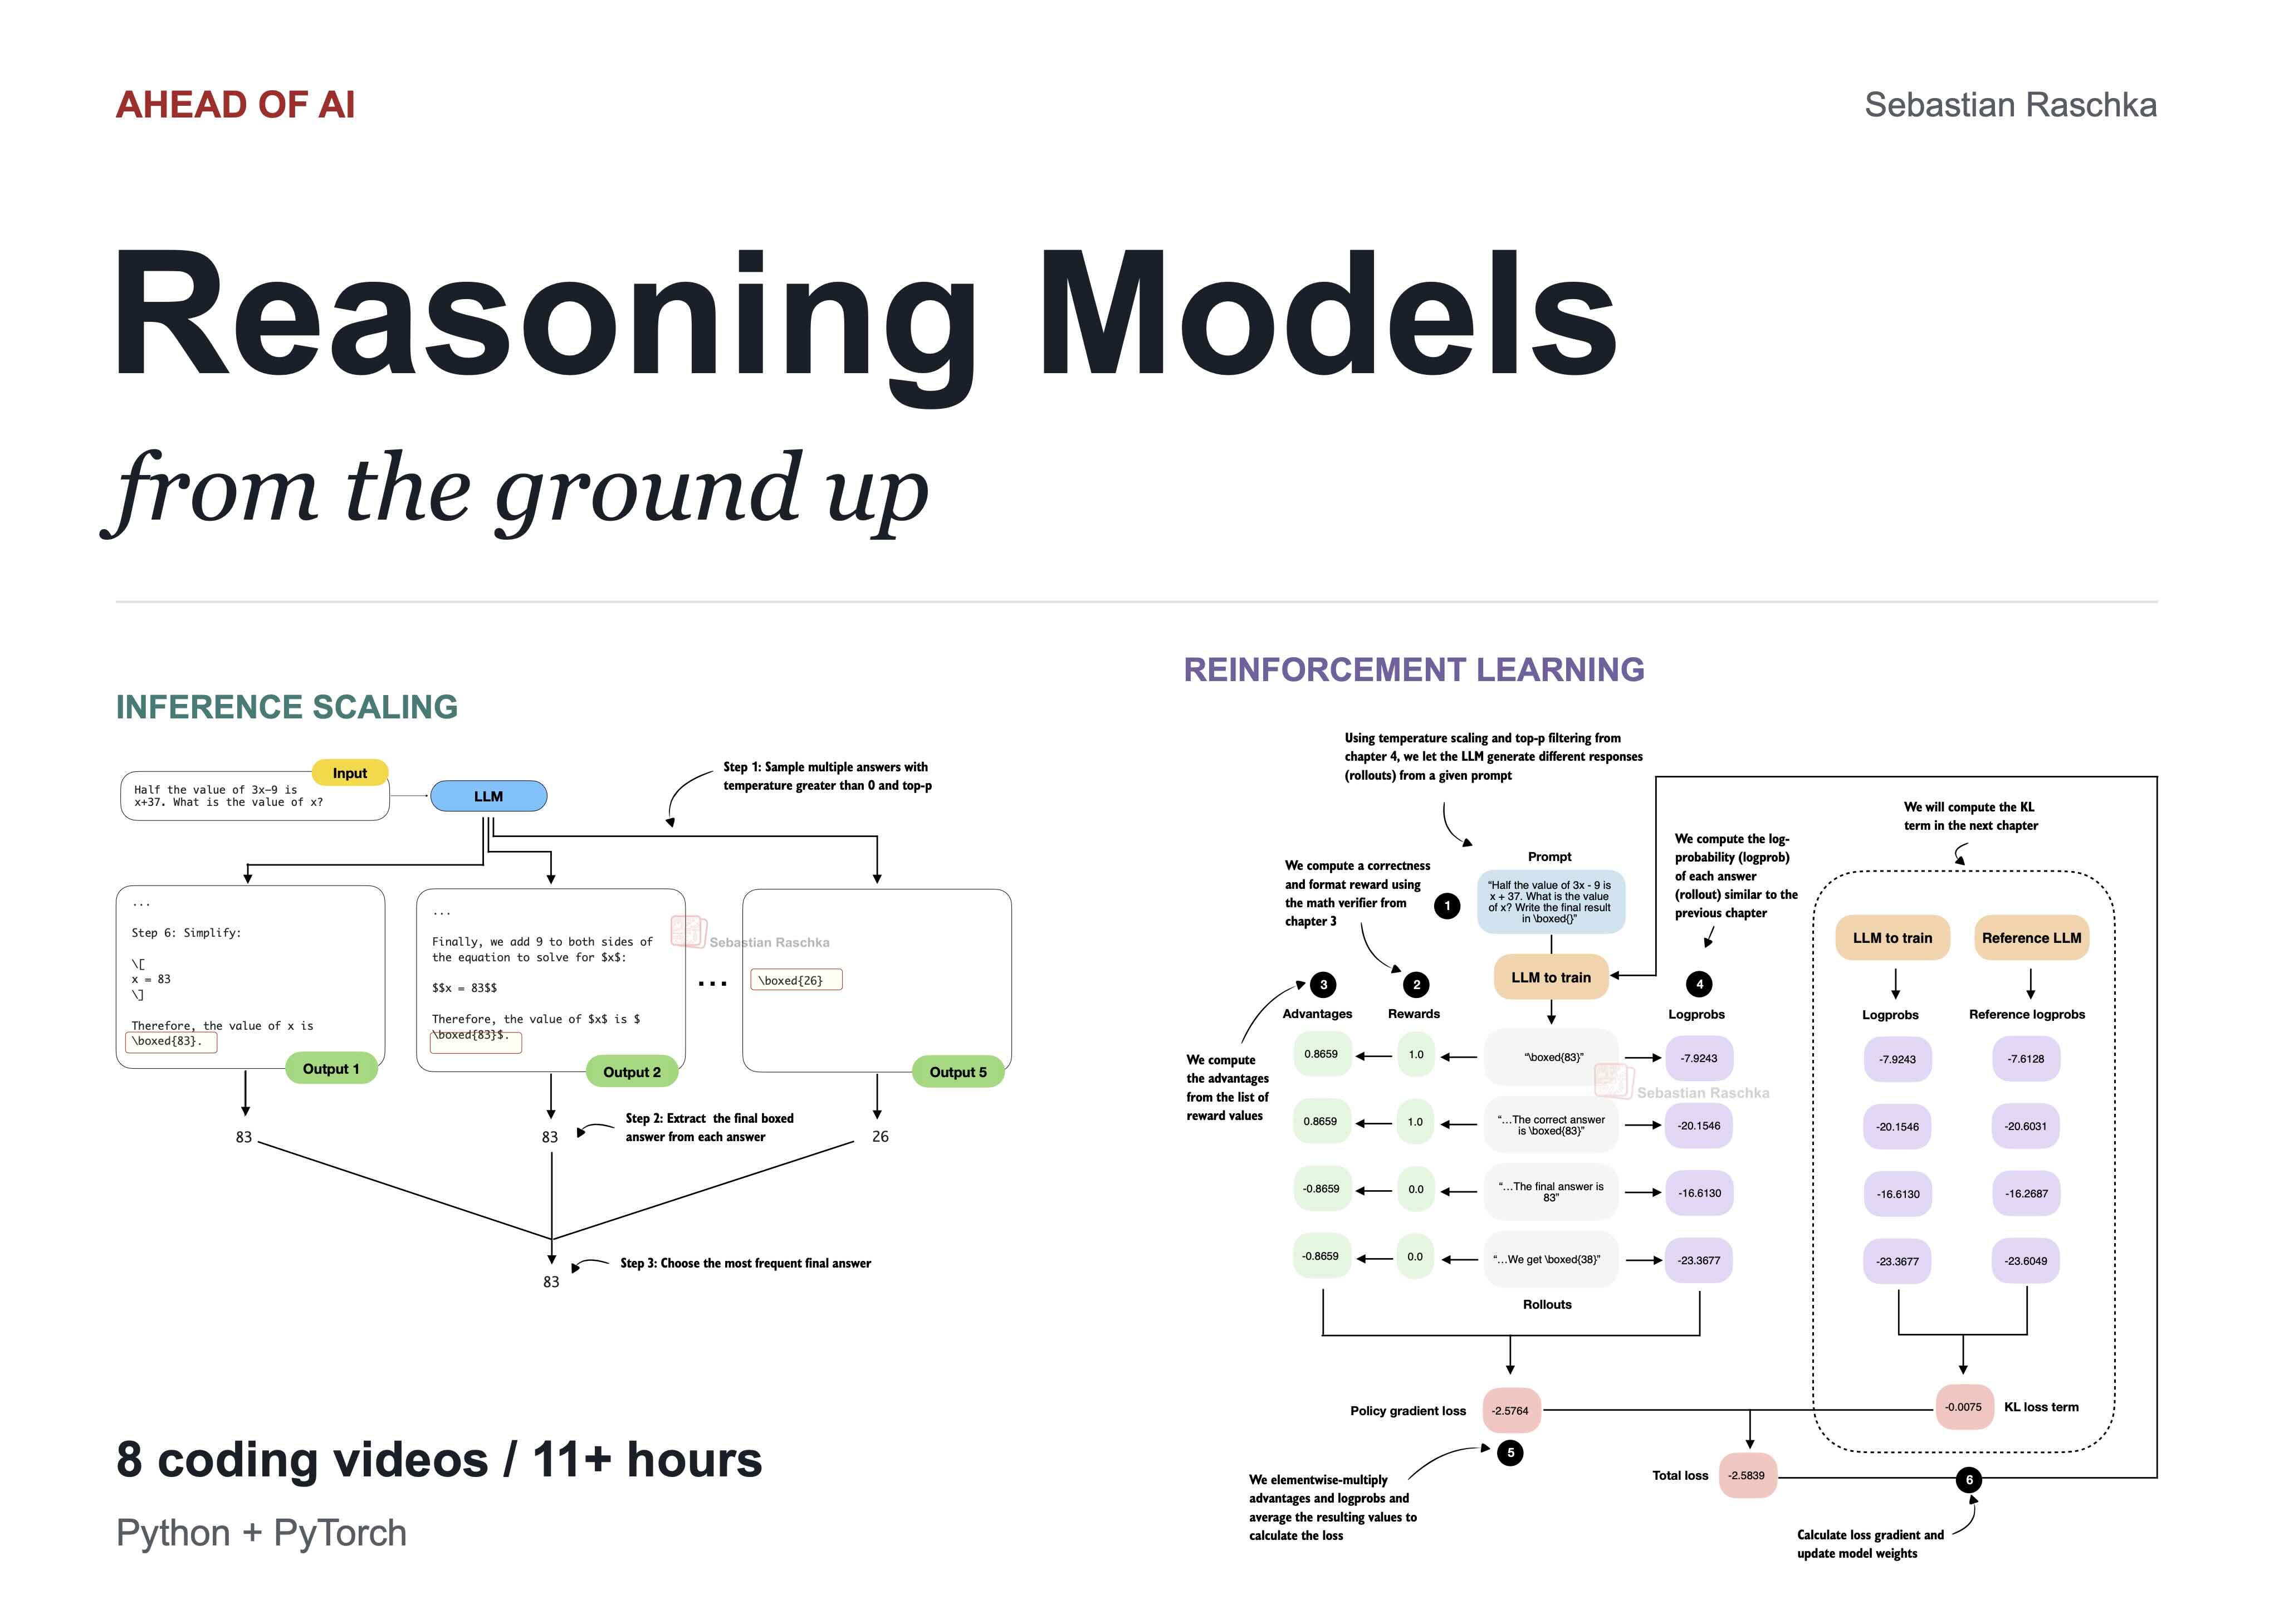
Claude · 2026-10-25세바스찬 라시카가 추론 모델을 처음부터 구현하는 11시간 분량의 8편짜리 코딩 강의를 공개했다. 사전학습된 Qwen3 모델을 기반으로 평가, 추론 시점 스케일링, 강화학습, 지식증류를 파이썬과 파이토치로 직접 구현하며, 저서 '밑바닥부터 만드는 추론 모델'과 함께 보도록 구성됐다. 강의는 텍스트 생성과 KV 캐싱 구현부터 검증기 제작, 다중 샘플링과 자기정합성, 자기개선, GRPO 기반 강화학습, 교사 모델을 활용한 지식증류까지 단계별로 다룬다. 초반은 CPU로도 학습 가능하지만 강화학습 등 후반 실습에는 GPU가 필요하며, 모든 강의 영상과 코드는 무료로 제공된다.
- 세바스찬 라시카가 추론 모델을 처음부터 구현하는 11시간 분량의 8편 코딩 강의를 공개했다.
- 사전학습된 Qwen3 모델로 평가, 추론 시점 스케일링, 강화학습, 지식증류를 직접 구현한다.
- GRPO 기반 강화학습과 교사 모델을 활용한 지식증류까지 단계별로 다룬다.
- 초반 실습은 CPU로 가능하지만 강화학습 등 후반에는 GPU가 필요하다.
- 저서 '밑바닥부터 만드는 추론 모델'과 함께 볼 수 있도록 구성됐다.
AI 인사이트
대상 독자:개발자
- 세바스찬 라슈카, 저서 'Build a Reasoning Model(From Scratch)' 연계 8편·11시간 분량 코딩 영상 공개
- Qwen3 0.6B 사전학습 모델로 시작해 평가·추론시점 스케일링·강화학습·증류를 파이토치로 직접 구현
- MATH-500 벤치마크로 자기일관성, 자기정제, GRPO 기반 RLVR, 증류 결과까지 단계별로 비교 평가
- 6번째 영상에서는 검증 가능한 보상(RLVR)을 활용한 단순화된 GRPO 학습 루프를 직접 구축
왜 중요한가
추론 모델의 핵심 기법(추론시점 스케일링, RLVR, 증류)을 블랙박스가 아니라 코드 수준에서 직접 구현해 보여주는 교육 자료로, 현재 주요 LLM 대부분이 추론 모드를 갖춘 시점에 실무자가 내부 동작을 이해하는 데 실질적 도움을 준다.
언급 프로젝트
본문 미리보기
Over 11 hours of coding videos on evaluation, inference-time scaling, reinforcement learning, and distillation, with Python and PyTorch.
전체 내용이 궁금하다면?
Ahead of AI (Sebastian Raschka)에서 원문을 직접 읽어보세요
공유
- #추론모델
- #강화학습
- #추론시확장
- #증류
이 글이 만들어진 과정
- 10:45AI 초안