이 글은 머신러닝의 기본 개념인 훈련·검증·테스트 데이터 분할을 초보자 대상으로 설명하는 가이드다. 훈련 데이터로 파라미터를 학습하고, 검증 데이터로 모델·설정을 선택하며, 테스트 데이터로 최종 일반화 성능을 추정하는 다섯 단계 과정을 소개하고, 동일 인물이나 시계열에 속한 데이터를 무작위로 나누면 정보 누수가 발생해 평가가 사실상 위장된 훈련이 되어버리는 흔한 실수를 경계해야 한다고 강조한다. 환자 기록은 방문 단위가 아닌 환자 단위로 분할해야 한다는 예시를 들며, 도입 여부를 판단할 때는 해결하려는 병목, 비교 기준선, 실패 사례, 운영 비용, 누수 감지 방법을 구체적으로 점검할 것을 권한다. AI 시스템이 더 큰 맥락과 도구 접근권을 갖게 되면서 이런 데이터 분할 원칙이 지연시간·보안·법적 책임에까지 영향을 미치는 실무적 문제가 되고 있다는 점이 핵심이다.
- •훈련·검증·테스트 분할은 파라미터 학습·모델 선택·최종 일반화 성능 추정을 위해 데이터를 나누는 기법
- •동일 인물·시계열 데이터를 무작위로 섮으면 정보 누수로 평가가 위장된 훈련이 될 수 있음
- •환자 기록은 방문이 아닌 환자 단위로 분할해야 한다는 예시로 설명
- •도입 전 목표, 기준선, 실패 사례, 운영 비용, 누수 감지 방법을 점검하라고 권장
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
What Is the Training, Validation, and Test Split? A Beginner’s Guide
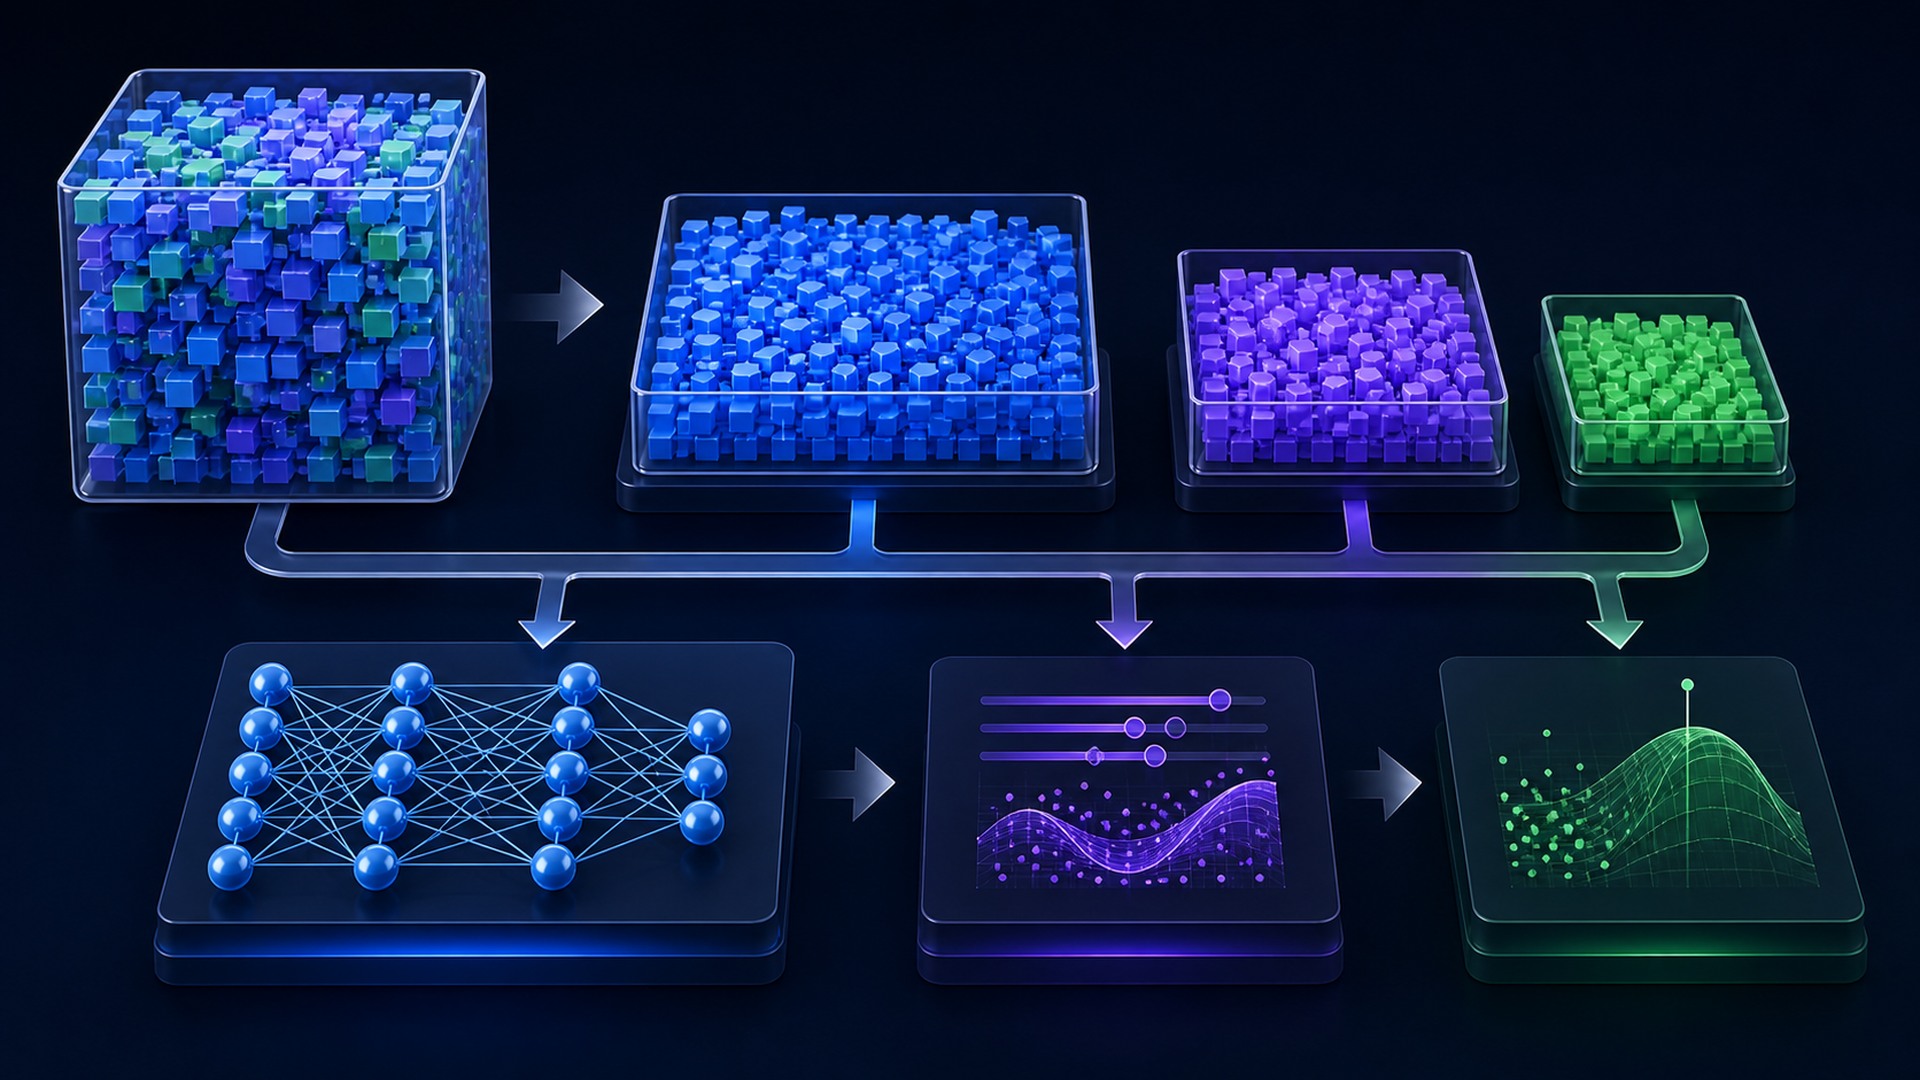
- 1.학습/검증/테스트 분할의 정의와, 데이터유출이 평가를 '위장된 훈련'으로 만드는 핵심 실패유형을 설명
- 2.동일인물·시계열 행이 훈련·테스트에 섞이는 무작위분할을 가장 흔한 오류 사례로 지목
- 3.정의→학습할당→검증·튜닝→테스트고정→불확실성포함 최종보고의 5단계 운영 프레임 제시
- 4.scikit-learn 가이드, 구글 Rules of ML, NIST AI RMF를 1차 참고자료로 안내
왜 중요한가?
그룹단위 데이터를 무작위분할하면 은밀한 유출로 모델성능이 과대평가될 수 있다는 점을 짚어, 평가 파이프라인 설계시 놓치기 쉬운 위험을 상기시킨다.
언급 프로젝트
본문 미리보기
A training, validation, and test split separates data used to fit parameters, choose models or settings, and estimate final generalization. This guide explains the mechanism, trade-offs, evaluation, and controls that matter in practice.
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:53AI 초안


