네이티브 오디오 모델은 음성을 텍스트로 변환하지 않고 음향 표현을 직접 처리·생성해 타이밍과 톤, 화자 특성 등 텍스트 전사 과정에서 사라지는 정보를 보존하는 방식이다. 이 가이드는 '음성→텍스트→음성 합성'을 거치는 파이프라인 방식과 구분해, 파형을 오디오 토큰으로 변환하고 맥락을 모델링한 뒤 의미를 추론하고 응답 오디오 토큰을 생성해 저지연으로 복원하는 5단계 작동 구조를 제시한다. 핵심 한계는 음성에 담긴 화자 신원, 감정, 배경음 등이 민감정보를 노출하거나 잘못된 추론을 유발할 수 있다는 점으로, 데이터 수집부터 평가·모니터링까지 이 위험을 고려해 설계해야 한다고 강조한다. 도입 전에는 해결하려는 구체적 병목, 베이스라인과의 비교, 실패 상황 대응 방안을 먼저 정의해야 한다는 평가 원칙도 제시됐다.
- •네이티브 오디오 모델은 전사 없이 음향 표현을 직접 처리·생성해 타이밍·톤·화자 정보를 보존
- •파형→토큰화→맥락 모델링→의미 추론→응답 생성→저지연 복원의 5단계 구조로 설명
- •텍스트 전사 후 음성 합성하는 파이프라인 방식과 명확히 구분되는 개념
- •화자 신원·감정·배경음 노출로 민감정보 유출이나 오판 유발 위험이 핵심 한계로 지적
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
What Are Native Audio Models? How Speech-to-Speech AI Skips Transcription
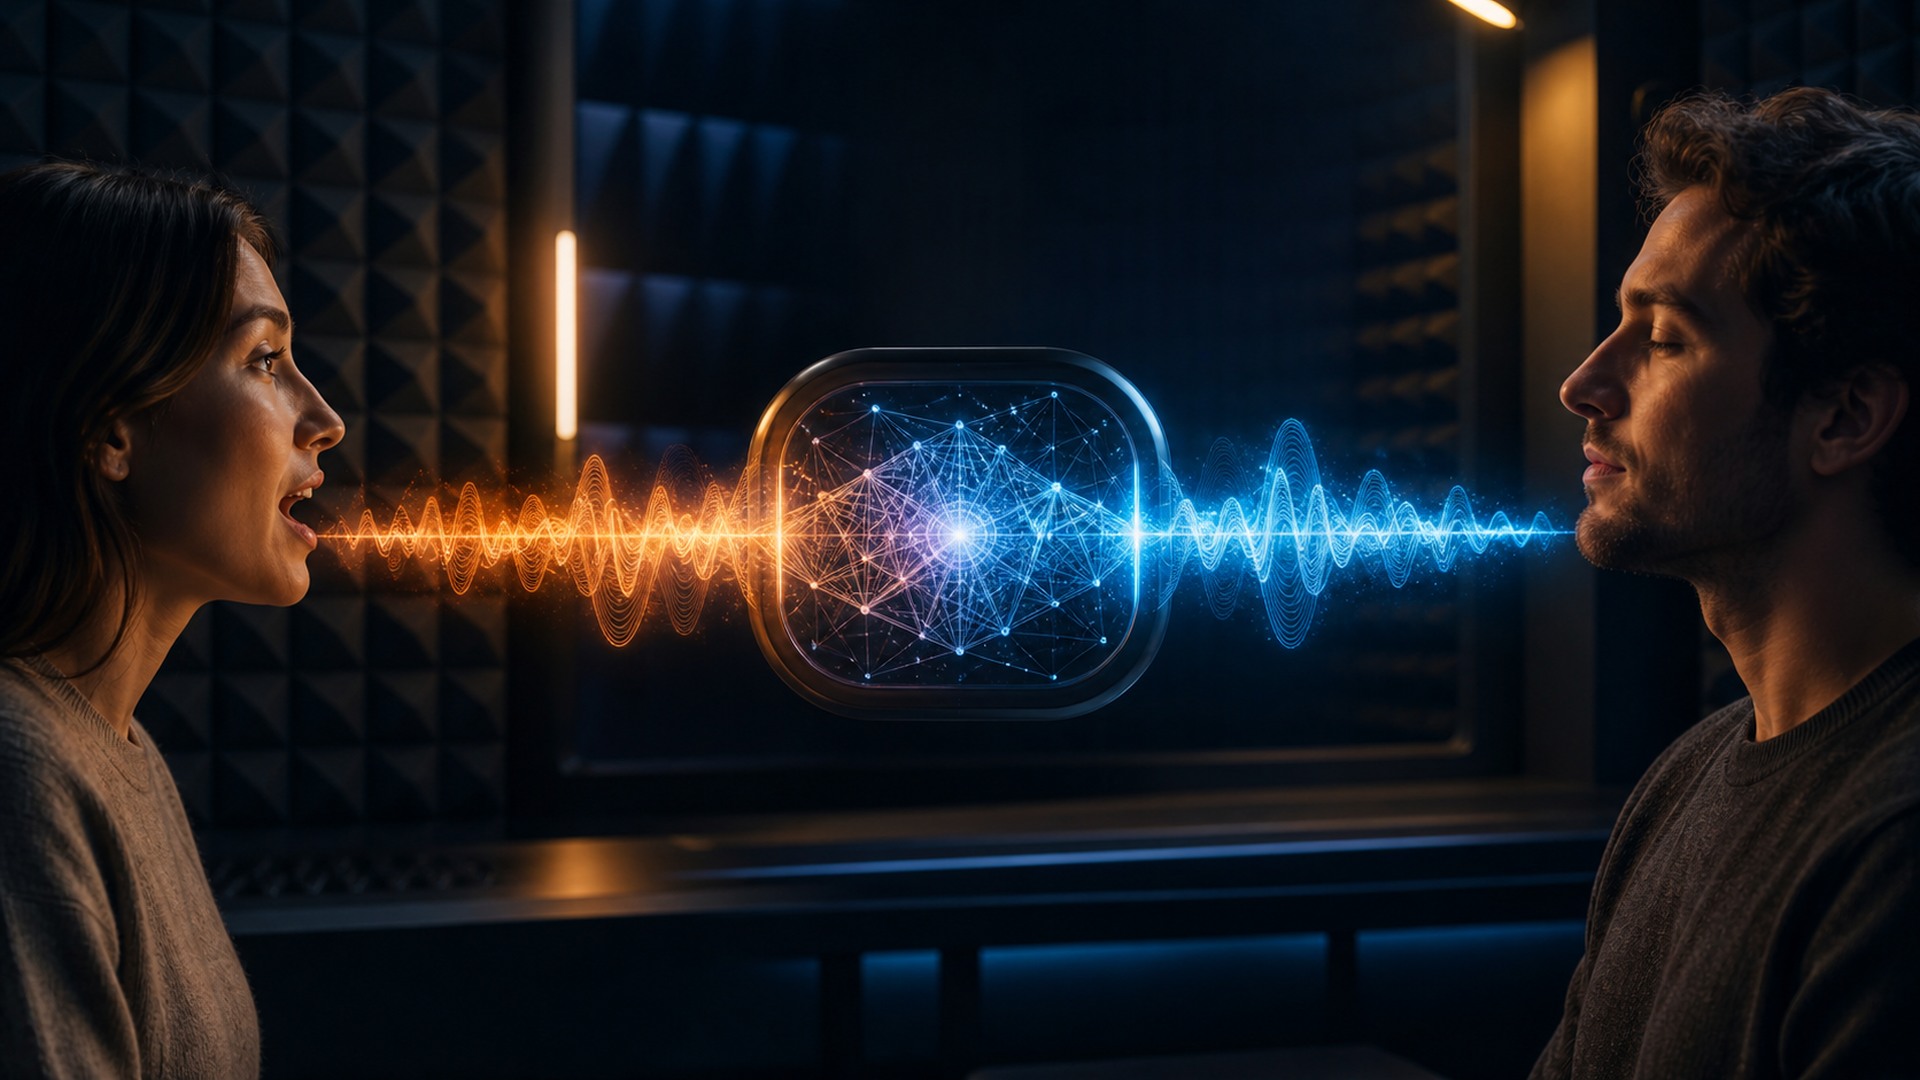
- 1.네이티브 오디오 모델은 음성을 텍스트로 변환하지 않고 음향 표현을 직접 처리·생성해 타이밍·억양·화자 정보를 보존
- 2.입력 변환→맥락 모델링→의미 추론→오디오 토큰 생성→음성 디코딩의 5단계 구조로 설명되는 개념
- 3.음성-텍스트-음성 변환 파이프라인과 달리 전사 과정의 정보 손실이 없다는 점이 핵심 차별점으로 제시됨
- 4.음성에서 화자 신원·감정·배경음 등 민감정보가 노출되거나 오판을 유발할 수 있다는 위험도 함께 지적
왜 중요한가?
이 설명은 '네이티브 오디오 모델'을 막연한 유행어가 아니라 TTS/STT 파이프라인과 구분되는 구체적 메커니즘으로 정의하려는 시도로, 음성 AI 제품을 평가·도입할 때 전사 기반 시스템과 네이티브 오디오 시스템을 어떤 기준으로 구별해야 하는지 틀을 제공한다.
본문 미리보기
Native audio models process or generate acoustic representations directly, preserving timing, tone, speaker cues, and other information that a text transcript discards. This guide explains the mechanism, trade-offs, evaluation, and controls that matter in practice.
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:53AI 초안