로봇 스타트업 다이나로보틱스가 원격조종 로봇 동작 데이터 없이, 인간이 작업하는 모습을 담은 영상 100만 시간만으로 신형 모델 'DYNA-2'를 학습시켰다. 기존 범용 로봇 정책은 사람이 로봇을 직접 조작하며 만든 원격조종 데이터에 의존해왔는데, 이런 데이터는 수집 비용이 크고 속도가 느려 로봇 파운데이션 모델의 확장을 제한하는 병목이었다. DYNA-2는 로봇에게 필요한 물리적 직관을 사람의 행동 영상에서 학습한 뒤 이를 실제 로봇 하드웨어로 전이할 수 있다는 가설을 검증하는 '월드-액션 모델(World-Action Model)'로 설계됐다.
- •다이나로보틱스, 원격조종 로봇 데이터 없이 인간 행동 영상 100만 시간으로 'DYNA-2' 학습
- •기존 로봇 정책은 사람이 로봇을 직접 조작하는 원격조종 데이터에 의존해 수집 비용·속도가 병목
- •DYNA-2는 인간 영상에서 학습한 물리적 직관을 로봇 하드웨어로 전이하는 '월드-액션 모델'로 설계
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
Dyna Robotics Trains DYNA-2 on a Million Hours of Human Video, No Robot Data
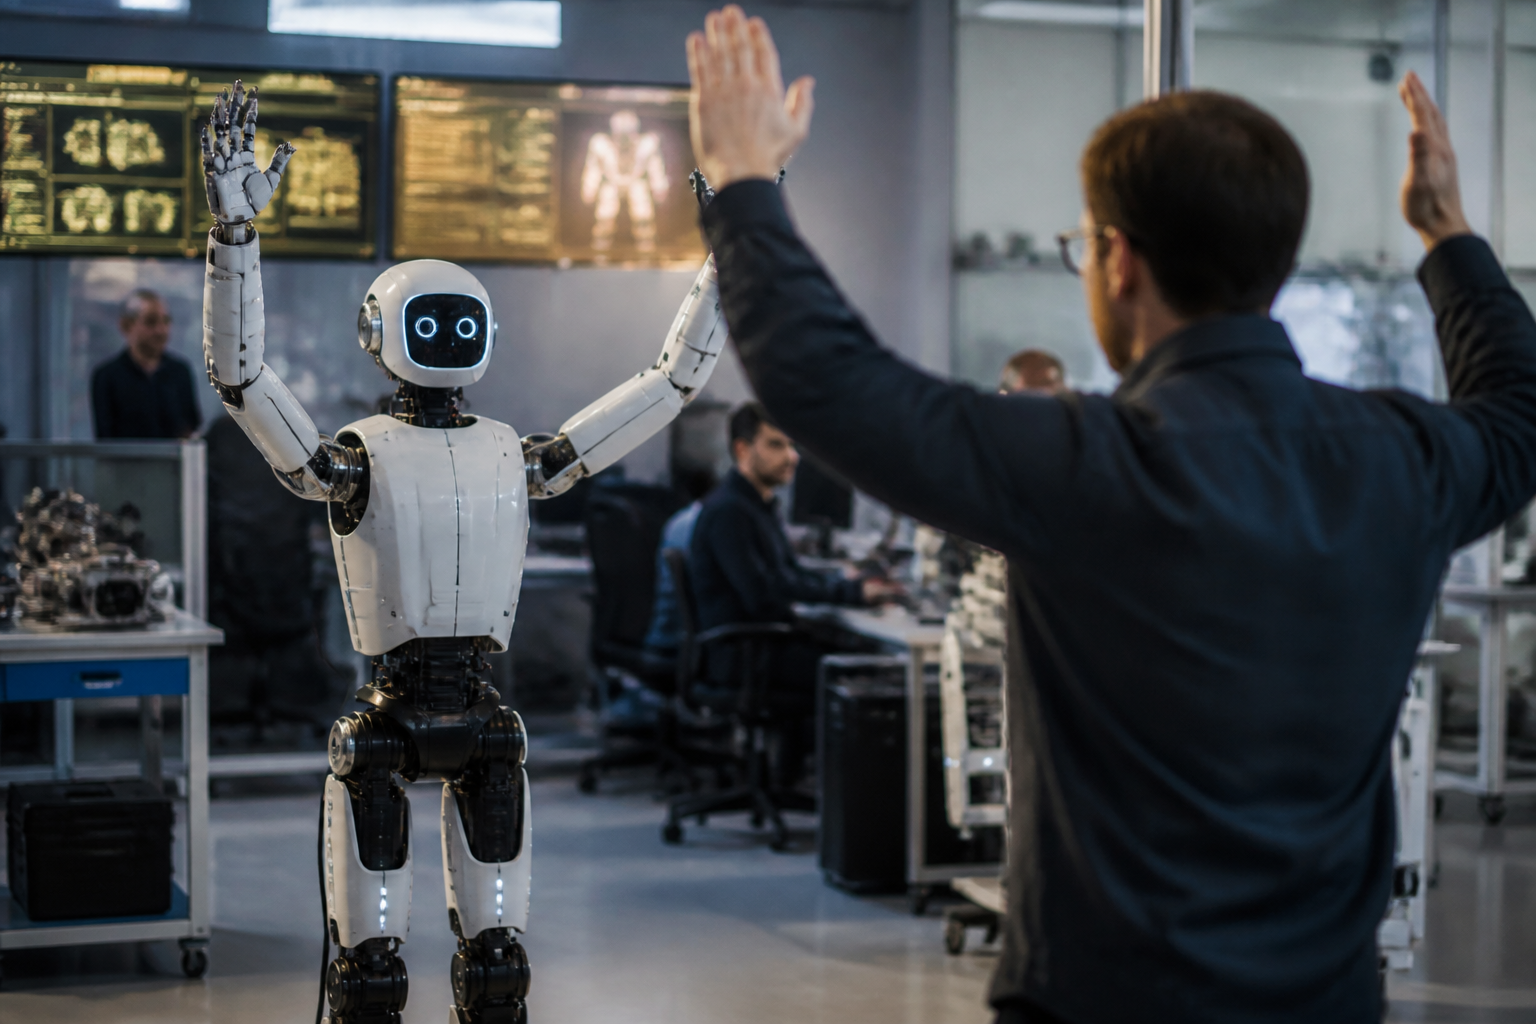
본문 미리보기
The claim matters because of where the field's constraint sits. Generalist robot policies have been trained largely on teleoperated action data: humans physically guiding robots through tasks, hour by hour. That data is expensive and slow to collect, and it has capped how far robot foundation models can scale. DYNA-2's bet is that the physical intuition robots need can be learned from video of humans doing things, then transferred to robot hardware. "By building a World-Action Model that…
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 11:11AI 초안


