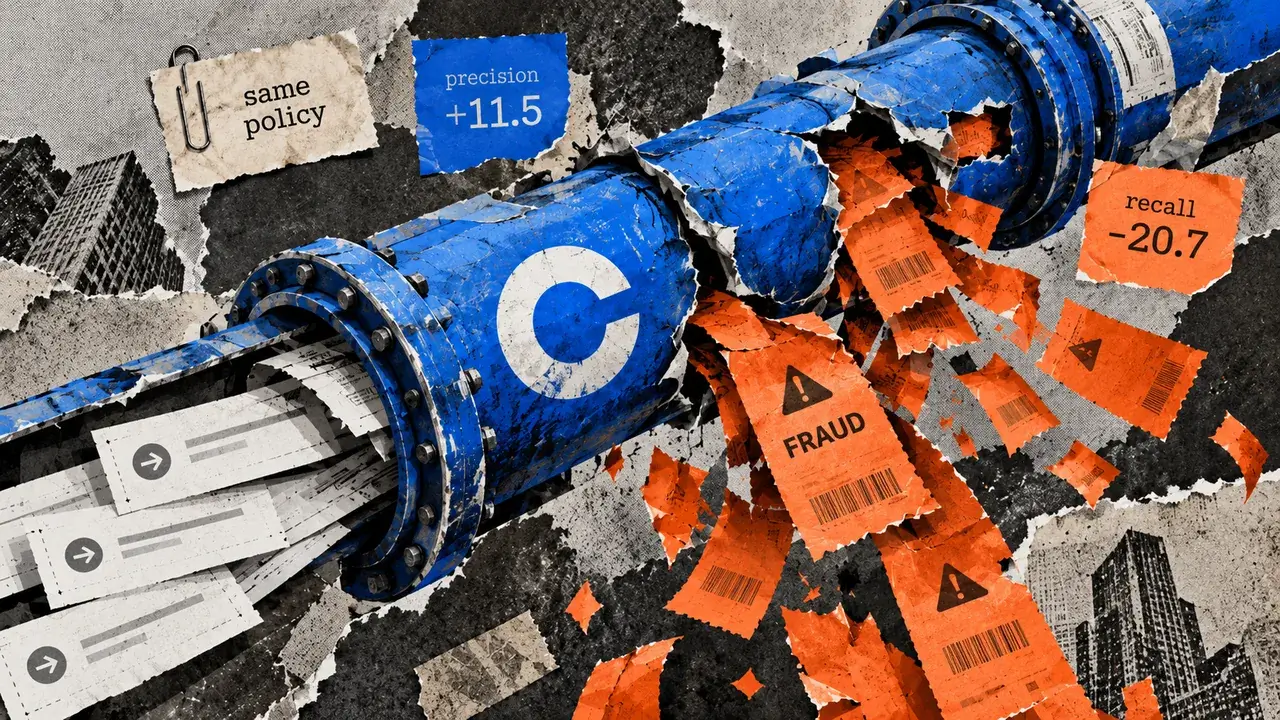
코인베이스가 10월 7일 발표한 평가에서 오퍼스, 소네트, GPT 등 세 모델 계열의 신버전이 결제 사기 탐지에서 구버전보다 더 낮은 적발률을 보였다고 밝혔다. 1만6140건의 거래를 재현한 테스트에서 소네트의 재현율(recall)은 22.2%포인트, 금액 가중 재현율은 22.9%포인트 하락했으며, GPT는 정밀도가 11.5%포인트 올랐지만 재현율은 20.7%포인트 떨어져 겉으로 좋아 보이는 지표가 실제로는 더 많은 사기를 놓쳤음을 보여줬다. 반면 코인베이스가 과거 사기 데이터로 직접 미세조정한 큐원3.5-9B 모델은 오퍼스 4.5보다 네 가지 사기 탐지 지표에서 모두 앞섰고 응답 지연도 55% 줄었다. 코인베이스는 모델을 업그레이드하기 전 실제 결정 체계에서 사기 탐지 성능을 먼저 검증해야 한다고 권고했다.
- •코인베이스, 오퍼스·소네트·GPT 신버전이 구버전보다 결제 사기 탐지율 낮다고 발표
- •소네트 재현율 22.2%포인트 하락, GPT는 정밀도 개선됐지만 재현율 20.7%포인트 급락
- •자체 미세조정한 큐원3.5-9B 모델은 오퍼스 4.5 대비 전 지표 우위, 지연 55% 감소
- •코인베이스, 실제 거래 손실까지 입증된 것은 아니며 원인도 특정하지 못했다고 명시
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
Newer AI models missed more payment fraud in Coinbase’s benchmark
- 1.코인베이스, Opus/Sonnet/GPT 3개 모델군 업그레이드 모두 과거 결제사기 재현테스트서 탐지율 하락
- 2.소네트는 recall 22.2%p·달러가중 recall 22.9%p 하락, GPT는 정밀도 11.5%p↑하지만 recall 20.7%p↓
- 3.16140건 거래·813건 사기사례 재현, 결정정책 고정한 채 모델만 교체해 비교
- 4.자체 파인튜닝한 큐원3.5-9B는 Opus 4.5보다 F1 9.6%p·달러가중 recall 35.4%p 개선
왜 중요한가?
범용 LLM을 최신 버전으로 업그레이드한다고 사기 탐지 성능이 자동으로 좋아지지 않으며, 오히려 정밀도 같은 한 지표의 개선이 전체 탐지력 저하를 가릴 수 있음을 보여줘, 금융 서비스가 모델 교체 전 실제 의사결정 환경에서 재검증해야 한다는 교훈을 준다.
본문 미리보기
A fixed historical replay found weaker fraud coverage across three model upgrades, while GPT’s precision improved. The post Newer AI models missed more payment fraud in Coinbase’s benchmark appeared first on CryptoSlate.
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:53AI 초안