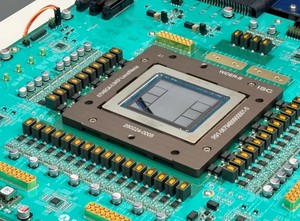
오픈AI가 자체 개발한 AI 추론 전용 칩 '할라페뇨'의 첫 성능 결과를 공개했다. GPT-OSS 120B, 딥시크 R1 670B, 키미 K2.5 1T 세 모델 테스트에서 기존 시스템 대비 와트당 AI 처리량이 최대 1.9배, 엔드투엔드 지연시간은 최대 3.6배 개선됐고, 대화형·에이전트 워크로드에서는 격차가 최대 4.1배까지 확대됐다. 700W급 칩을 랙당 128개, 최대 16개 랙에 걸쳐 2048개까지 연결할 수 있으며, 128개 칩 구성은 4비트 연산 기준 약 1.7엑사플롭스와 27.5TB HBM4 메모리를 제공한다. 오픈AI는 할라페뇨를 GPU 대체가 아닌 워크로드별 최적 실리콘을 선택하는 포트폴리오 전략의 일환으로 제시했으며, 올해 말부터 자체 인프라에 배치하고 2·3세대 칩도 이미 개발 중이라고 밝혔다.
- •할라페놀, 3개 공개모델 테스트에서 와트당 AI 처리량 최대 1.9배, 지연시간 최대 3.6배 개선
- •대화형·에이전트 워크로드에서는 성능 격차 최대 4.1배까지 확대
- •700W급 칩을 최대 2048개까지 연결, 128개 구성 시 약 1.7엑사플롭스·27.5TB HBM4 제공
- •GPU 대체가 아닌 워크로드별 최적 실리콘을 조합하는 포트폴리오 전략
- •올해 말 자체 인프라 배치 시작, 2·3세대 칩 개발도 이미 진행 중
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
오픈AI, 자체 AI 추론칩 ‘할라페뇨’ 성능 전격 공개… “와트당 AI 처리량·응답속도 모두 잡았다”
본문 미리보기
오픈AI(OpenAI)가 자체 개발한 인공지능(AI) 추론 전용 칩 ‘할라페뇨(Jalapeño)’의 첫 성능 결과를 공개했다. 단순히 GPU를 대체하는 자체 칩을 개발하는 수준을 넘어, AI 모델부터 추론 소프트웨어, 메모리, 네트워크, 칩, 데이터센터 시스템까지 전체 컴퓨팅 스택을 직접 최적화하는 전략이 구체적인 성능 지표로 모습을 드러냈다는 점에서 주목된다.오픈AI는 25일(현지시간) 할라페뇨의 첫 번째 실측 결과를 전격 공개하면서, 이 칩은 기존 상용 AI 시스템과 비교해 더 적은 전력으로 더 많은 AI 작업을 처리하면서 동시
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:11AI 초안