비전-언어 모델(VLM)은 이미지를 시각 토큰으로 인코딩하고 텍스트와 결합해 설명·검색·추론 등을 수행하는 멀티모달 AI 시스템이다. 기사는 이미지 인코딩, 텍스트 인코딩, 두 표현의 연결, 영역·구문 간 주의(attention), 응답 디코딩까지 5단계 작동 구조로 VLM을 설명한다. 가장 큰 한계는 유창한 설명이 실제로 이미지에 존재하지 않는 객체나 관계를 지칭할 수 있다는 점으로, 이를 막기 위한 평가와 모니터링 체계가 필요하다고 강조한다. 단순 라벨 분류형 컴퓨터 비전과 달리 VLM은 개방형 언어로 추론하므로, 도입 전 측정 가능한 목표와 기준선 비교, 실패 사례 검증이 필수라는 점을 시사한다.
- •VLM은 이미지 인코딩→텍스트 인코딩→표현 연결→주의(attention)→응답 디코딩의 5단계로 작동
- •핵심 한계는 유창한 설명이 실제 이미지에 없는 객체·관계를 지칭할 수 있다는 점
- •고정 라벨만 예측하는 전통적 컴퓨터 비전과 달리 개방형 언어로 추론·설명 가능
- •도입 전 측정 가능한 목표 설정과 기준선 대비 성능 비교, 실패 사례 검증이 필요
0단 자동
AI가 규칙대로 쓰고 그대로 게시했습니다. 사람이 따로 보지 않았습니다.
- 규칙 판
- 규칙 판 도입 이전 기사입니다.
- 남기는 것
- 규칙 판 · 모델 · 시각
- 판 기록
- 아직 없습니다.
What Are Vision-Language Models (VLMs)? How AI Connects Images and Words
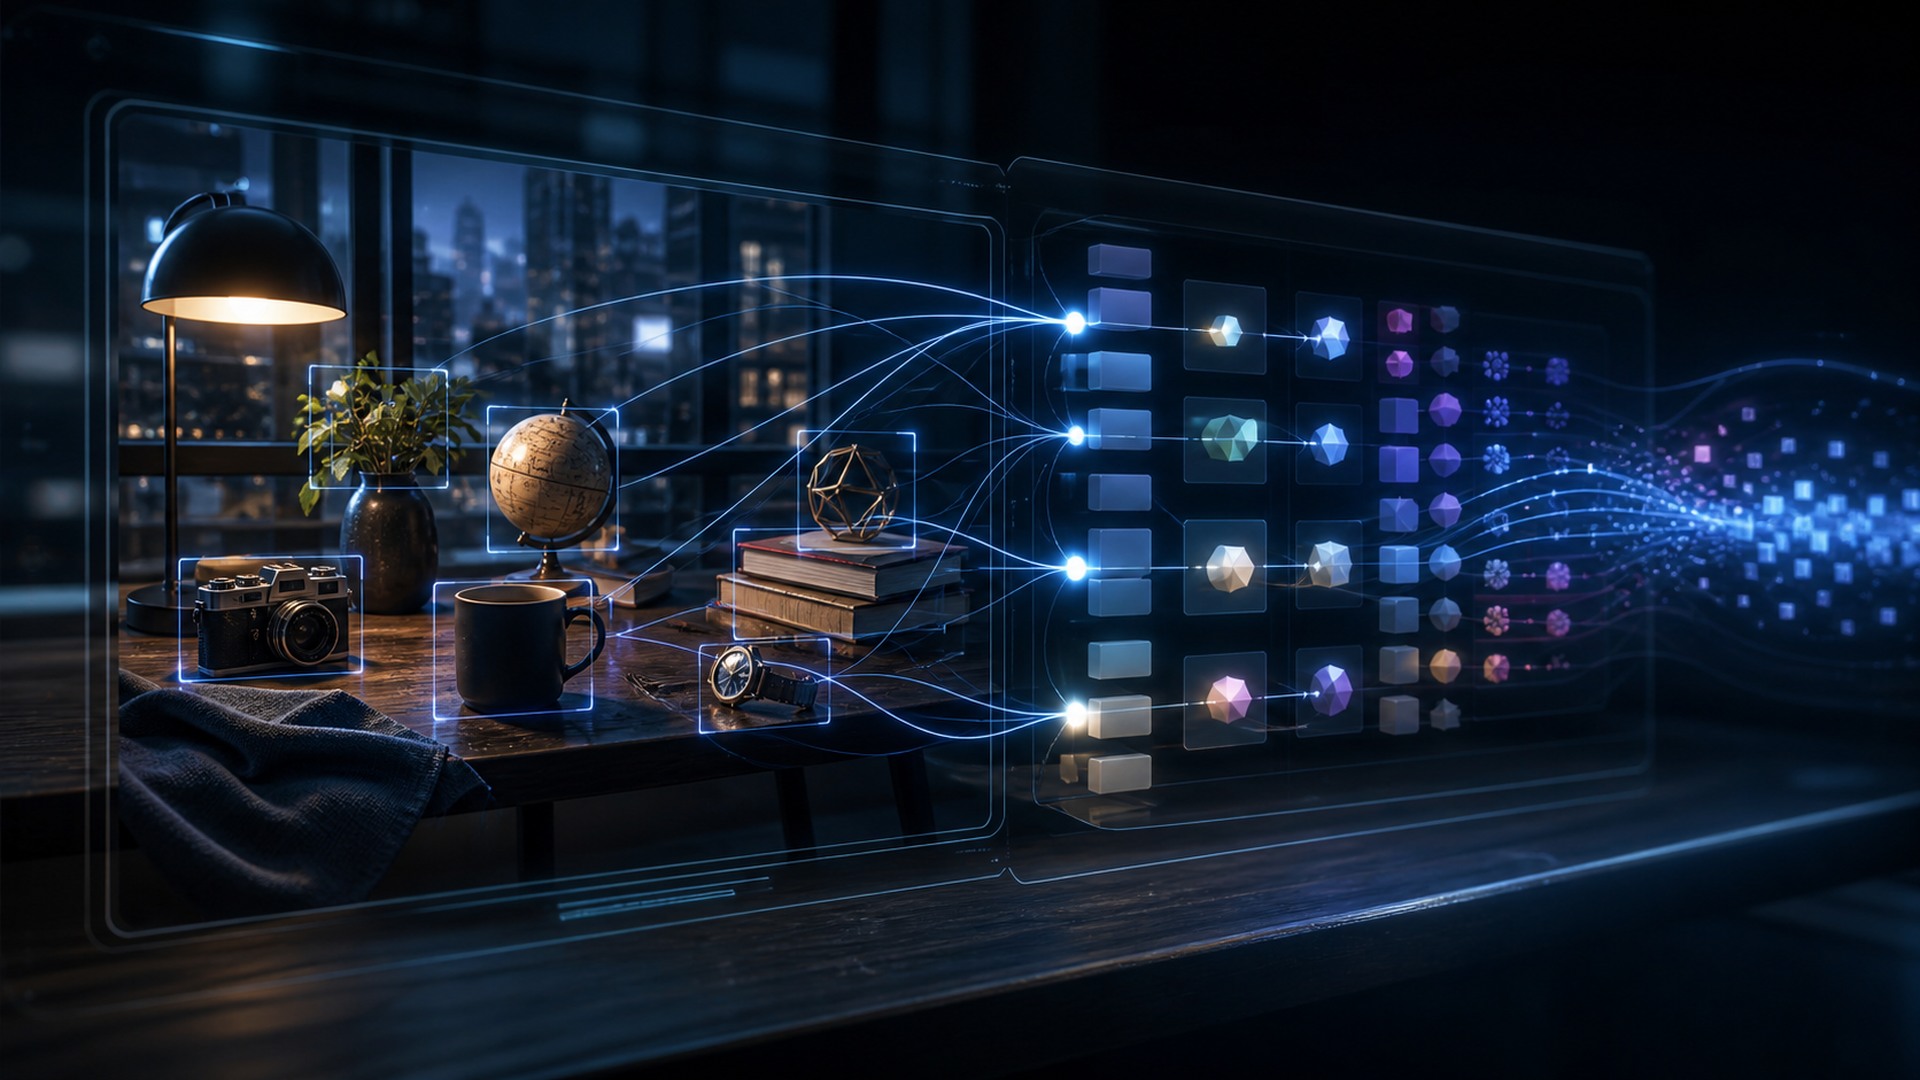
- 1.비전-언어모델(VLM)을 이미지 인코딩→텍스트 인코딩→표현 결합→어텐션→응답 디코딩 5단계로 정의하는 개념 가이드
- 2.핵심 한계로 '유창한 설명이 실제로 보이지 않는 대상·관계를 지어낼 수 있다'는 환각 위험을 지목
- 3.고정 라벨만 예측하는 전통 컴퓨터비전과 VLM을 구분해야 한다고 설명, 하위집단별 실패율·꼬리지연 분리 보고를 권고
- 4.참고자료로 CLIP 논문과 PaLM-E 임바디드 멀티모달 모델을 제시
왜 중요한가?
새 연구 결과나 제품 출시가 아니라 VLM 개념을 체계적으로 정리한 입문용 글로, 구체적 수치나 신규 모델 비교는 없지만 VLM 도입 팀이 평가 설계와 그라운딩 실패 위험을 점검할 체크리스트 역할을 한다.
본문 미리보기
Vision-language models connect visual features with language so a system can describe, compare, retrieve, or reason about images using words. This guide explains the mechanism, trade-offs, evaluation, and controls that matter in practice.
전체 내용이 궁금하다면?
원문을 직접 읽어보세요
이 글이 만들어진 과정
- 10:53AI 초안



